TMJ第二轮训练结果
概述
TMJ 数据收集第二轮之后的训练记录。
训练过程记录
Yolov8过程
先将数据通过 labelme2yolov8 转换成 Yolov8 训练需要的格式。
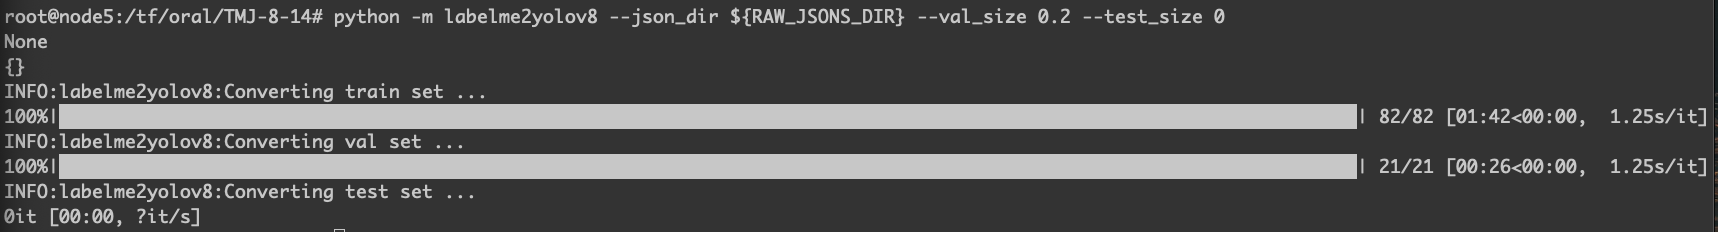
按照参数,80%作为训练集,20%作为验证集,这里说明一下,参数和比例后面都可以调节的,主要是初步看一下结果。
标记图片。
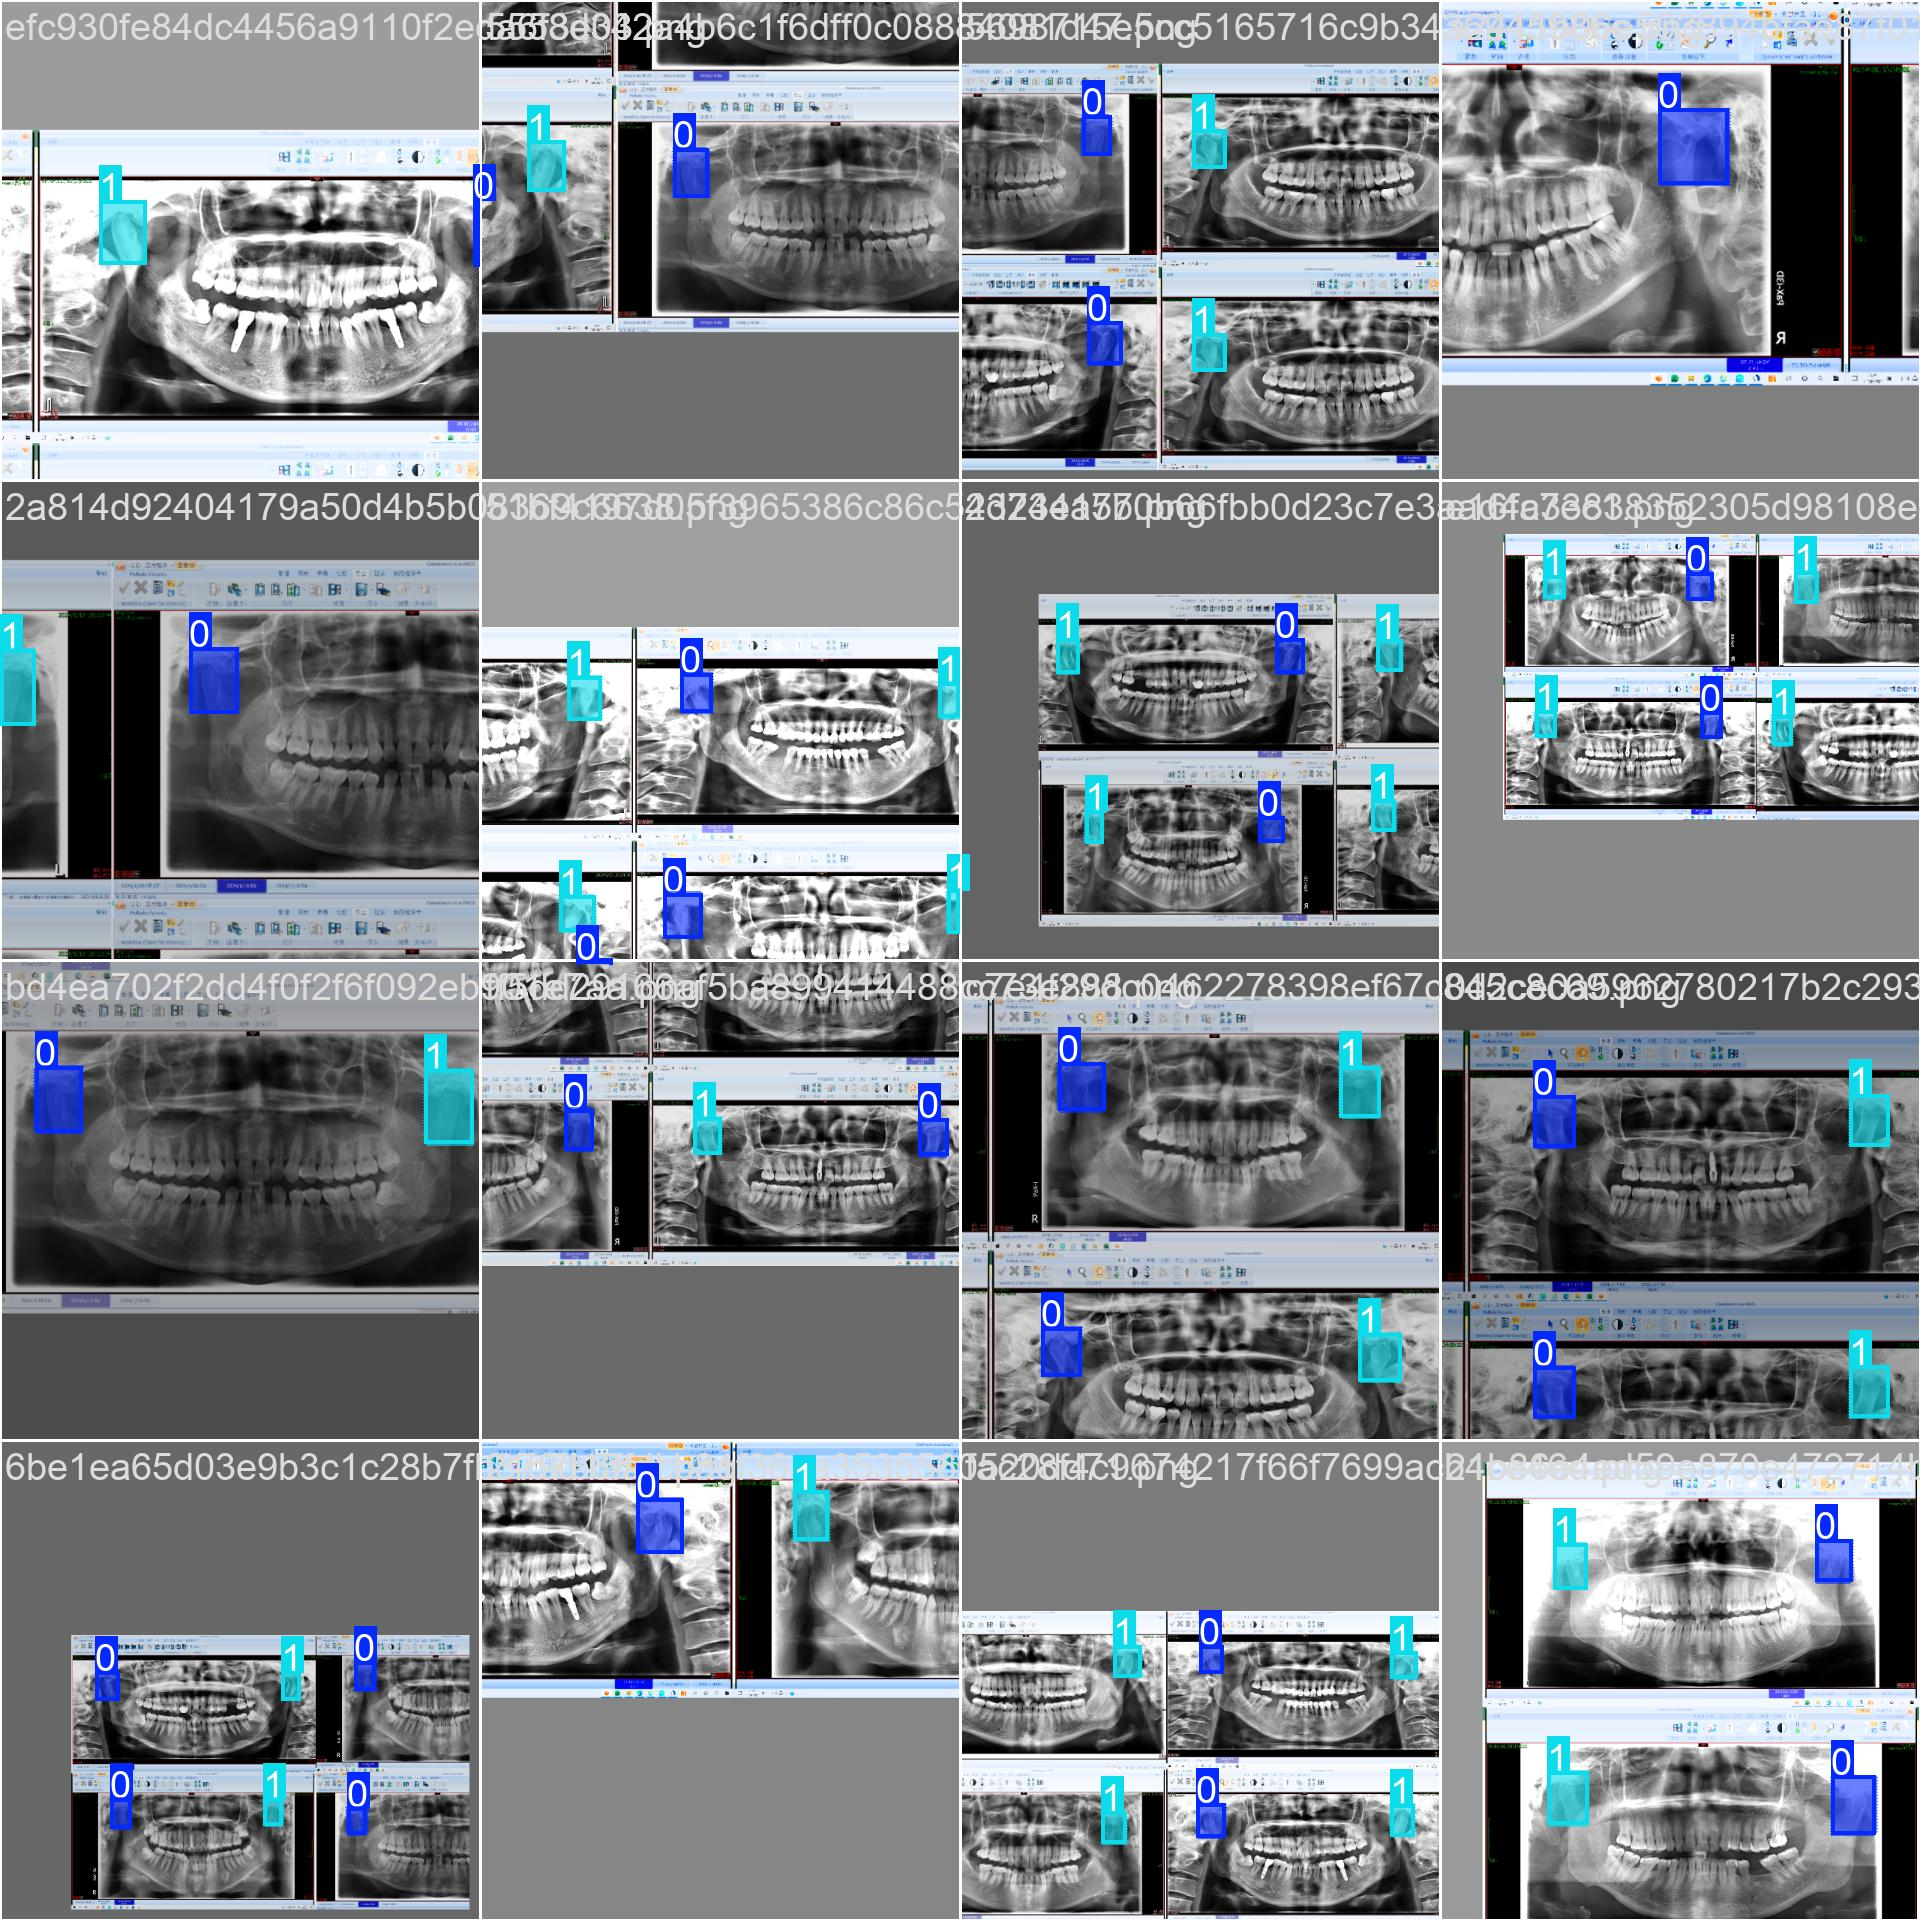
如果想看 WandB 的指标可以后面再加,想快速出结果的话,暂时把 WandB 拿掉会比较快。模型结果保存后,使用模型来对所有的图片进行分割和标记。
seg代表分割,annotated代表标记
从分割的结果看,似乎还是跟上次的问题类似,为什么呢。后面会写个总结,回顾一下这个问题。
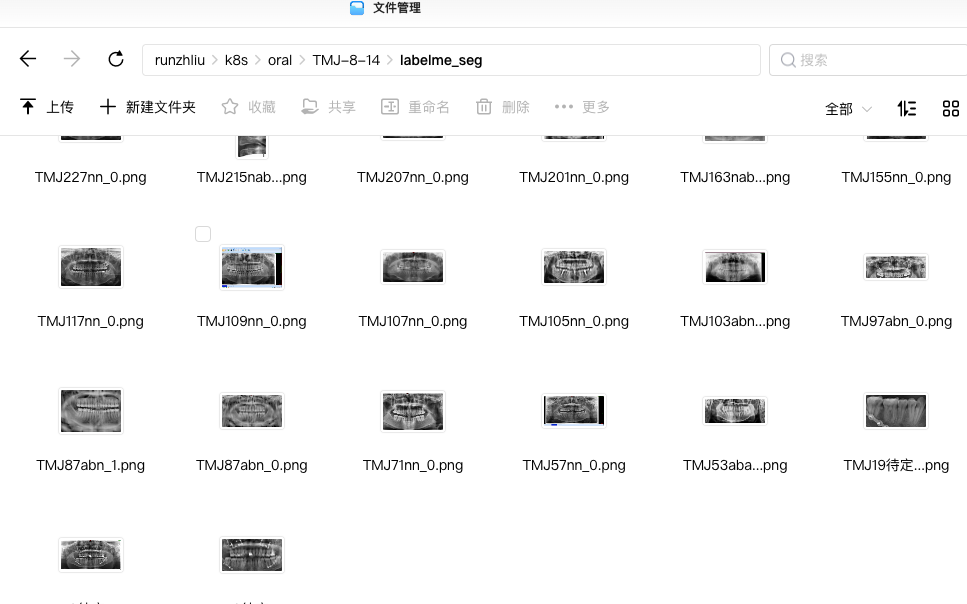
尝试通过代码,以 labelme 的结果来做图片的裁剪,效果是不错的,为什么训练的过程里,完全没学到呢,按道理来说数据量已经不少了,100张图片还不够么。
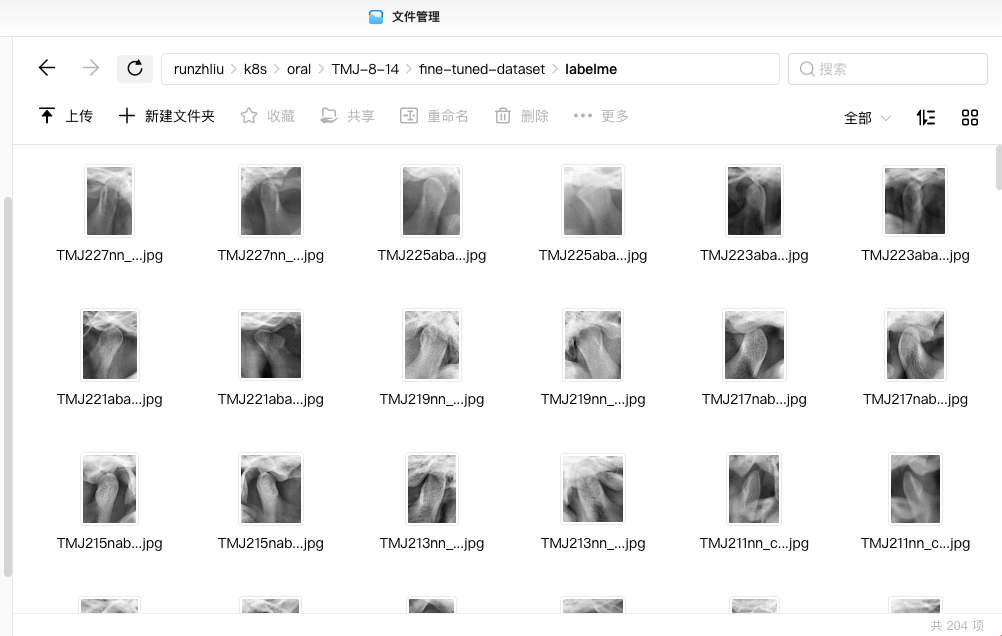
可以看到labelme裁剪出来的结果都是好的
CNN过程
因为 Yolo 训练效果不佳,先用 labelme 的数据试一下。因为数据集不符合标准格式,需要花点时间做一下数据集。
TMJ227nn.png 通过 corp 程序,可以裁剪出 TMJ227nn_cropped_1.jpg TMJ227nn_cropped_2.jpg。
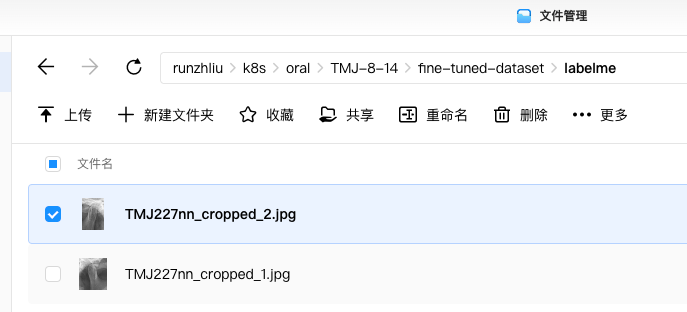
因为不确定 _1 是左还是右,按我理解,先判断成右吧,所以所有 _1 都代表右侧,_2 都代表左侧了,根据文件名前缀,TMJ227nn,第一个 n 算右侧的吧,第二个 n 算左侧的吧,所以单张图片有下面的演化关系。
TMJ227nn.png
|
TMJ227nn_cropped_1.jpg // 代表右侧为n
TMJ227nn_cropped_2.jpg // 代表左侧为n
再举几个例子。
TMJ225abab.png
|
TMJ225abab_cropped_1.jpg // 代表右侧为ab
TMJ225abab_cropped_2.jpg // 代表左侧为ab

TMJ217nab.png
|
TMJ217nab_cropped_1.jpg // 代表右侧为n
TMJ217nab_cropped_2.jpg // 代表左侧为ab
关于 CNN 的训练,因为跟之前有人工模型的图片那样,所以这次训练应该是从头训练的,或者是拿 VGG 这些去做 fine tuned,测试过程中,先用 CNN 有个稳定不错的结果之后再考虑用 VGG 等预训练完的网络。
数据还需要再整理一下,要将 n 和 ab 的分别挑出来,并且分出左右,整理出下面的文件夹和图片数量。
# tree -d
.
├── abab
│   ├── left //左ab * 26
│   └── right //右ab * 26
├── ab_left //左ab * 8
├── ab_right //右ab * 10
├── nn
│   ├── left //左n * 57
│   └── right //右n * 57
├── n_left //左n * 10
└── n_right //右n * 8
重新整理数据之后,可以专门挑 n_left 和 ab_left 或者 n_right 和 ab_right 的图片来做 CNN。
| 类别 | 图片数量 |
|---|---|
| n_left | 57+10 |
| ab_left | 26+8 |
| n_right | 57+8 |
| ab_right | 26+10 |
因为图片区分了n和ab之后,又区分了左右,这样会导致数据量减少,数据少意味着效果不好
虽然这样分类之后数据少,但可以试一下把模型代码跑跑看。
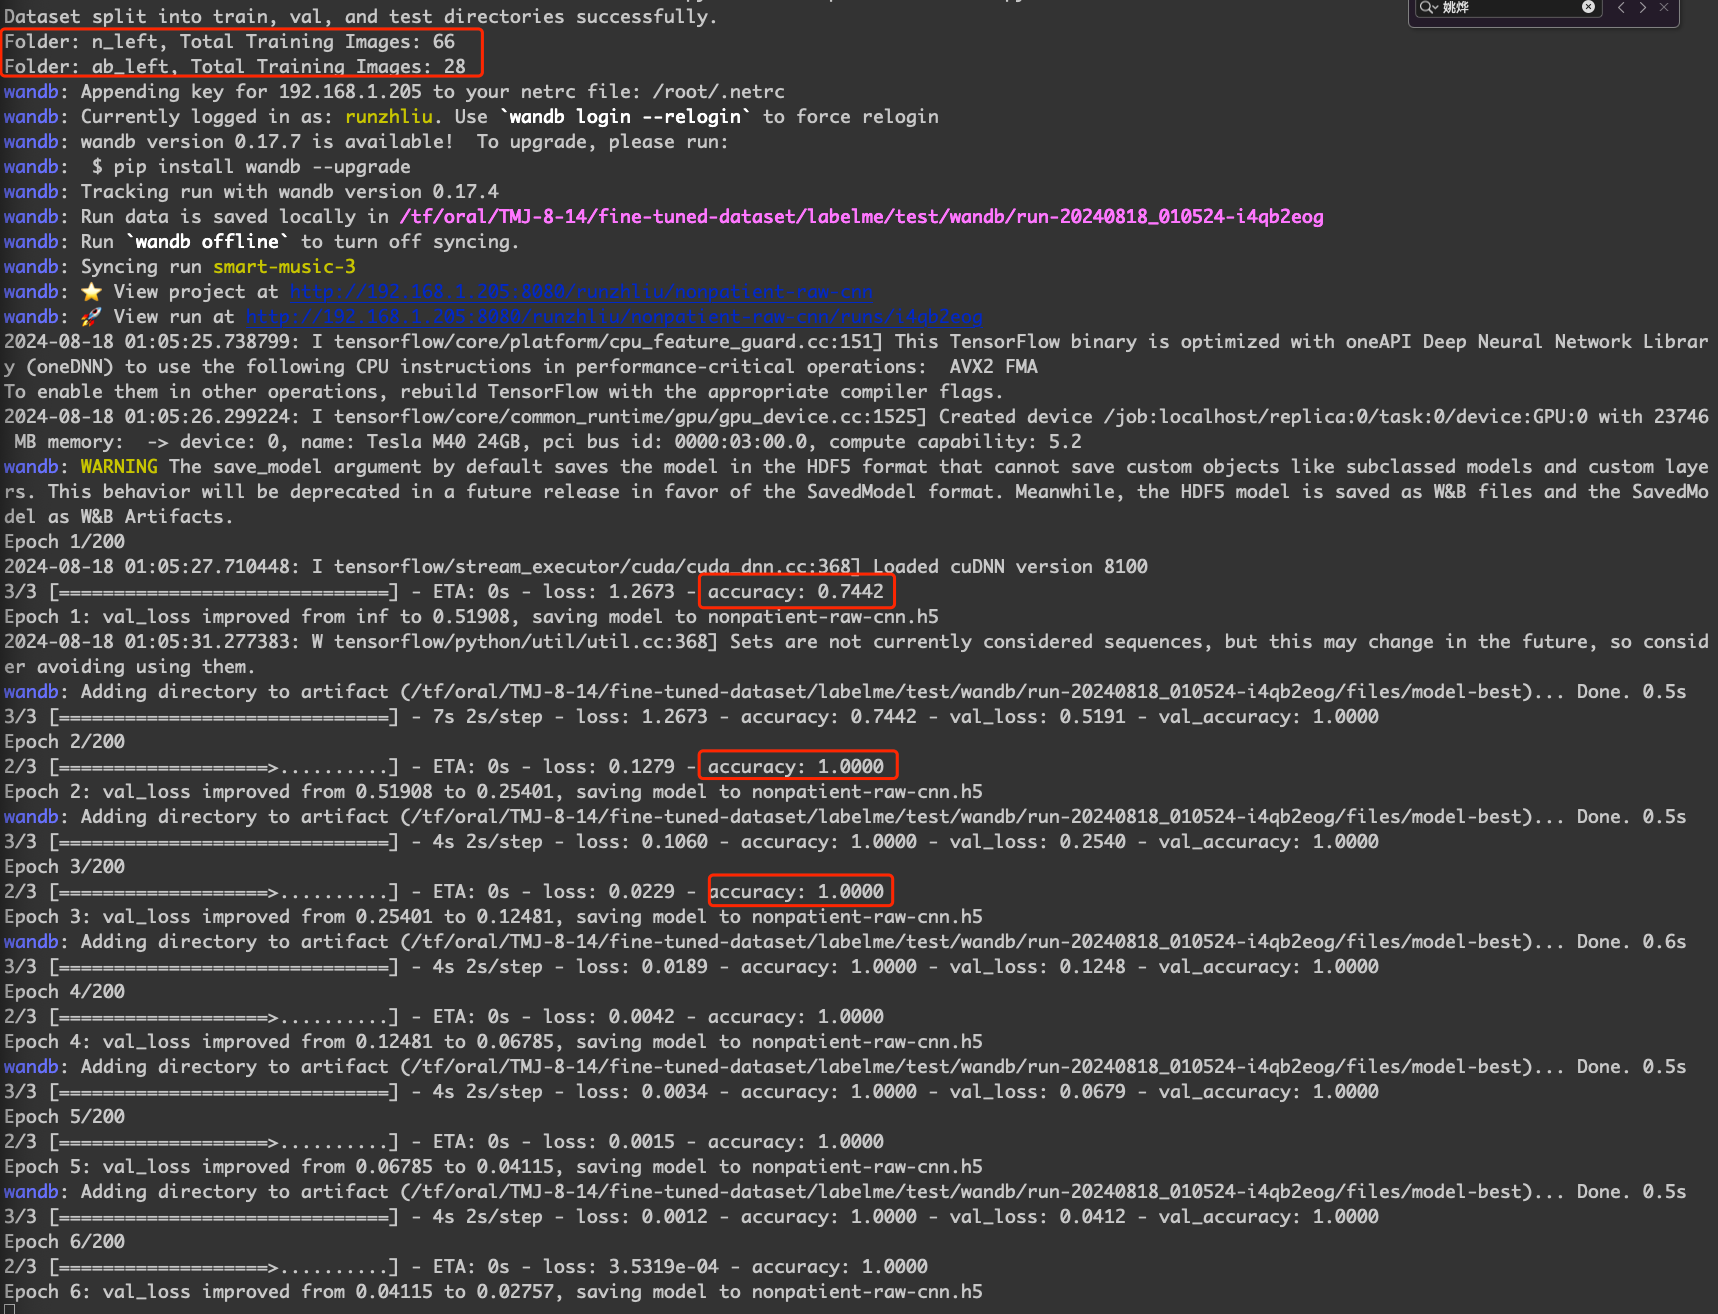
数据量太少了,一下子就过拟合了
数据集的问题
为了方便后面的工作,两类图片应该分开在不同的文件夹。
一些想法
如果是一张图片有左右两个部位,每个部位都评估为 N-Normal/AB-Abnormal,可否将左、右两部分图片通过翻转成为一种图片,来增加数据量呢。
总结
没有 Yolo 的情况下,数据还是比较少的,CNN 效果不好,接下来应该花点时间研究一下 Yolo 效果不佳的原因,还是希望可以通过人工标记一部分数据,然后通过 Yolo 来发现更多数据来做图片分类。